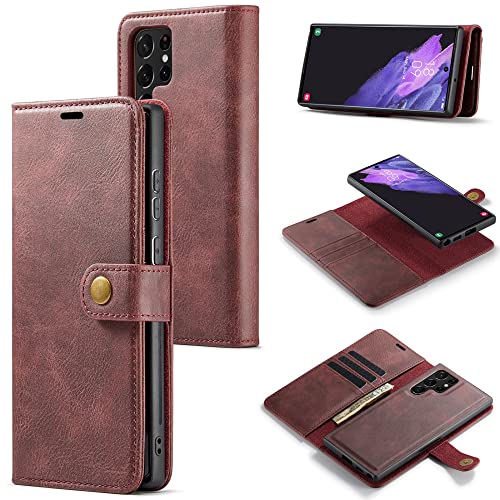
Étui de téléphone à rabat en cuir noir pour trajets quotidiens
13,99 EUR
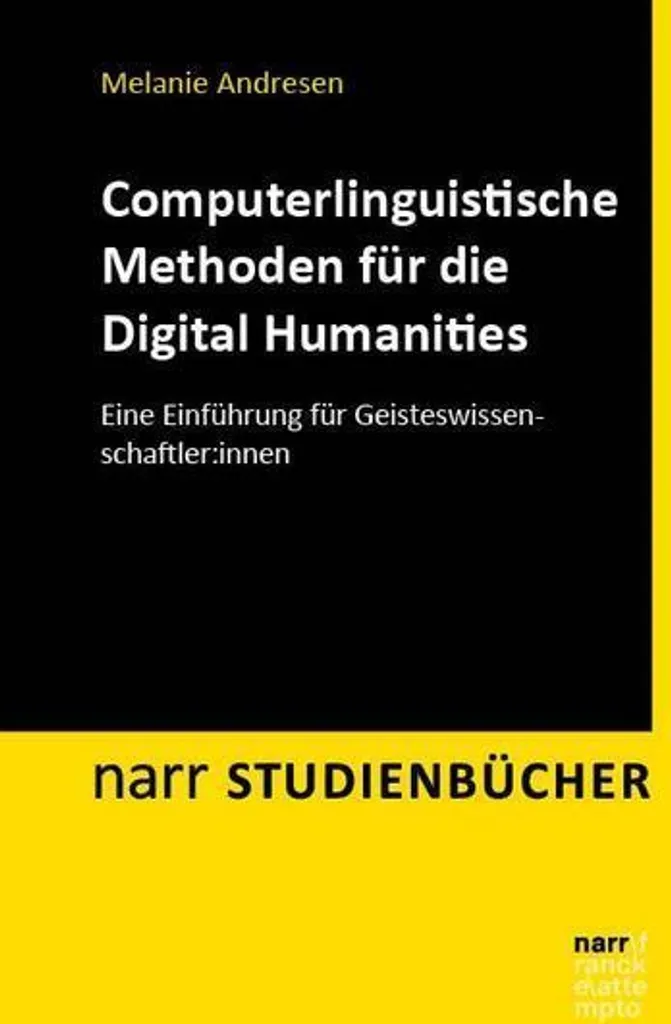
Cet ouvrage de référence explore l'intersection fascinante entre le traitement automatique du langage et la recherche en sciences sociales. Il propose une approche structurée pour intégrer les outils numériques dans l'analyse de corpus textuels complexes.
Grâce à une pédagogie rigoureuse, les lecteurs découvrent comment les algorithmes transforment la compréhension des textes historiques et littéraires. Le contenu aborde les fondamentaux de la modélisation statistique appliquée aux données linguistiques.
Ce guide technique détaille les flux de travail essentiels, de l'acquisition des données à leur interprétation finale. Il constitue une ressource indispensable pour structurer vos projets de recherche académique avec une précision mathématique.
Les chapitres sont organisés pour permettre une progression fluide entre la théorie pure et l'application concrète des outils de traitement. Vous y trouverez des solutions aux défis courants de la numérisation et de l'indexation sémantique.
En adoptant ces méthodologies, les chercheurs optimisent leur temps de traitement tout en minimisant les erreurs d'interprétation manuelle. C'est l'outil parfait pour moderniser vos pratiques de recherche documentaire traditionnelle.
La vérification de votre environnement a échoué. Connectez-vous pour consulter les avis.